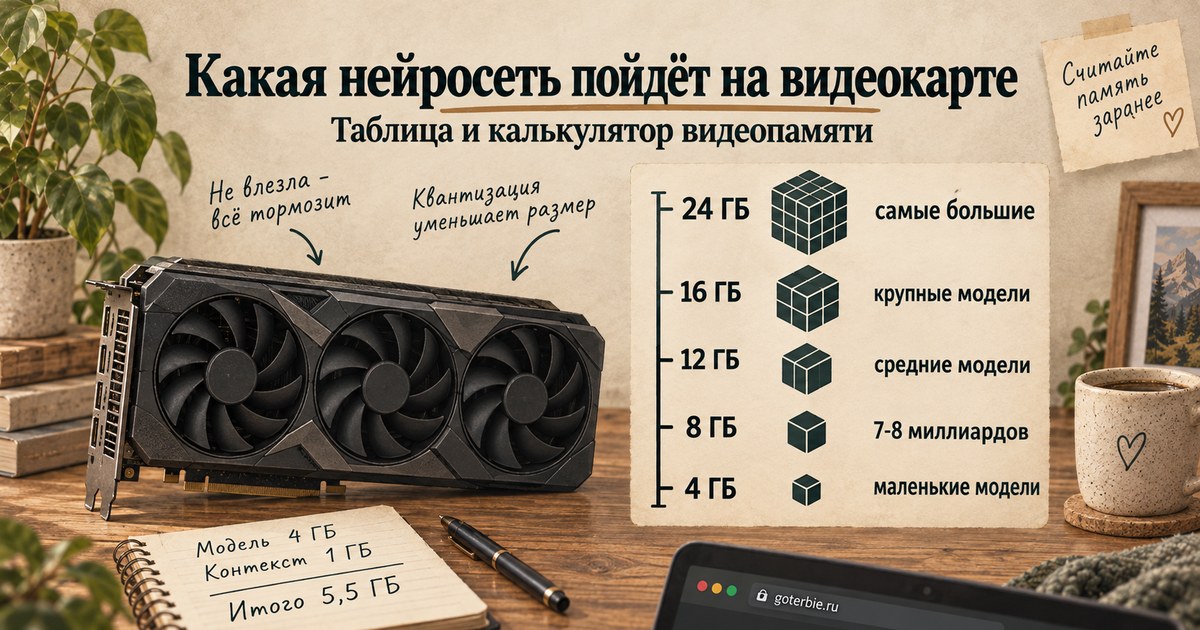
Прежде чем качать нейросеть на свой компьютер, полезно заранее понять, поместится ли она в видеокарту. От этого зависит всё: одна и та же модель на одной и той же карте может писать ответ в четыре раза быстрее или медленнее, чем на процессоре. Главная цифра здесь - объём видеопамяти, а не модель видеокарты и не её «мощность».
Ниже калькулятор, который считает это за секунду, таблица для популярных объёмов видеопамяти и объяснение, откуда берутся цифры. Для проверки я сверял расчёт с настоящими замерами на карте AMD Radeon RX 6500 XT с 4 ГБ из статьи Нейросеть на своём компьютере: Ollama с нуля.
Коротко
- Модель должна поместиться в видеопамять целиком. Если не помещается, часть уходит на процессор, и скорость падает в разы.
- Грубое правило: модель в обычном сжатии Q4 занимает около 0,6 ГБ на каждый миллиард параметров, плюс 1-2 ГБ на контекст и служебные нужды.
- 4-6 ГБ: модели на 2-4 миллиарда параметров. 8 ГБ: до 8 миллиардов. 12 ГБ: до 14 миллиардов. 16 ГБ: gpt-oss:20b. 24 ГБ: модели на 24-31 миллиард.
- Длинный контекст (много текста в одном разговоре) съедает дополнительно от сотен мегабайт до нескольких гигабайт.
Калькулятор видеопамяти
В режиме «Что пойдёт на мою видеокарту» выберите объём видеопамяти, и калькулятор покажет, какие из 20 популярных моделей влезут. В режиме «Сколько нужно памяти» выберите модель или введите число параметров, и он разложит расход по частям.
Объём видеопамяти своей карты можно посмотреть в Windows: Ctrl+Shift+Esc → вкладка «Производительность» → «Графический процессор», строка «Выделенная память графического процессора».
Названия моделей в калькуляторе совпадают с каталогом Ollama, их можно сразу вставить в команду ollama run. Размеры моделей взяты из того же каталога.
Как считать самому
Память под нейросеть складывается из трёх частей.
1. Веса модели. Это сама нейросеть, основная часть расхода. Считается так: число параметров × сколько бит занимает один параметр ÷ 8. В обычном сжатии Q4_K_M, которое Ollama качает по умолчанию, на параметр приходится около 4,9 бита.
2. Кэш контекста. Модель запоминает каждое слово разговора, чтобы учитывать его в ответе. Чем длиннее разговор или документ, тем больше памяти.
3. Запас. Драйвер видеокарты, служебные буферы программы, у моделей, которые понимают картинки, ещё и буфер под изображения. Обычно от 0,5 до 1,5 ГБ.
Пример для популярной модели llama3.1:8b на 8 миллиардов параметров:
| Часть | Расчёт | Итого |
|---|---|---|
| Веса | 8 млрд × 4,9 бита ÷ 8 = 4,9 млрд байт | 4,6 ГБ |
| Кэш контекста | 128 КБ на токен × 4096 токенов | 0,5 ГБ |
| Запас | драйвер и буферы | 0,7 ГБ |
| Всего | 5,8 ГБ |
Значит, на карте с 6 ГБ эта модель поместится только впритык, и то если монитор подключён к другой видеокарте. Уверенно она пойдёт на карте с 8 ГБ.
Откуда 128 КБ на токен: у этой модели 32 слоя, в каждом хранится по 8 пар «ключ-значение» размером 128 чисел, каждое число занимает 2 байта. 2 × 32 × 8 × 128 × 2 = 131 072 байта. Токен - кусочек текста, в русском языке обычно часть слова: страница текста - это примерно 600-700 токенов.
Ещё одна поправка: если к видеокарте подключён монитор, часть памяти занимает сама Windows. На моей карте с 4 ГБ Ollama видел свободными 3,4 ГБ.
Какая видеокарта для какой модели
Оценка для обычного сжатия Q4_K_M, контекста 4096 токенов и монитора, подключённого к этой же карте.
| Видеопамять | Какие модели пойдут целиком | Для чего хватит |
|---|---|---|
| 4 ГБ | llama3.2:3b; модели на 4 млрд (qwen3.5:4b, gemma3:4b) только частично | письма, пересказ, перевод, простые вопросы |
| 6 ГБ | модели на 2-4 млрд: qwen3:4b; qwen3.5:4b и gemma3:4b впритык | то же, но быстро и с запасом под контекст |
| 8 ГБ | модели на 8 млрд: llama3.1:8b, qwen3:8b; qwen3.5:9b без монитора на этой карте | заметно умнее ответы, работа с документами средней длины |
| 12 ГБ | модели на 9-14 млрд: qwen3.5:9b, gemma4:12b, gemma3:12b, deepseek-r1:14b | рассуждения, помощь с кодом, длинные тексты |
| 16 ГБ | gpt-oss:20b впритык, модели на 12-14 млрд с длинным контекстом | серьёзная ежедневная работа |
| 24 ГБ | модели на 24-31 млрд: mistral-small3.2:24b, qwen3.5:27b, gemma4:26b; gemma4:31b впритык | качество, близкое к простым облачным сервисам |
Реальный опыт с картой на 4 ГБ описан в статье про Ollama. Главная находка оттуда: модель gemma4:e2b не помещается в 4 ГБ даже наполовину, но всё равно выдала 32 токена в секунду при хорошем русском языке. Она устроена иначе, чем остальные: большая часть её файла - справочные таблицы (эмбеддинги), которым не так страшно лежать в оперативной памяти. Калькулятор для неё честно показывает «в основном на процессоре», но на практике это одно из немногих исключений.
Что такое квантизация
Нейросеть - это миллиарды чисел. В исходном виде каждое занимает 16 бит (формат FP16). Квантизация - это сжатие: числа округляют и хранят в 8, 5 или 4 битах. Файл становится в 2-4 раза меньше, модель работает быстрее, а качество падает совсем немного.
| Сжатие | Бит на параметр | Размер модели на 8 млрд | Потери качества |
|---|---|---|---|
| FP16 | 16 | 16 ГБ | нет, это оригинал |
| Q8_0 | 8,5 | 8,5 ГБ | практически незаметны |
| Q5_K_M | 5,7 | 5,7 ГБ | очень малы |
| Q4_K_M | 4,9 | 4,9 ГБ | малы, это выбор по умолчанию |
| Q3 и ниже | 3-4 | 3-4 ГБ | заметны |
Цифры потерь есть в исследовании 2026 года на модели Llama 3.1 8B: средний результат по набору тестов у оригинала 69,5 балла, у Q8_0 - 69,4, у Q5_K_M - 69,4, у Q4_K_M - 69,2. А вот у сильного сжатия Q3_K_S уже 65,5 балла, падение ощутимое.
Практический вывод: берите Q4_K_M (Ollama качает его по умолчанию). Если памяти хватает с запасом, можно взять Q8_0, но разницу в обычном чате вы вряд ли заметите. Лучше потратить лишнюю память на модель побольше: модель на 14 миллиардов в Q4, как правило, умнее модели на 8 миллиардов в Q8.
Контекст и почему он ест память
Контекст - это сколько текста модель держит в голове за один разговор: ваши вопросы, её ответы, вставленный документ. Для каждого токена хранится кэш, и он растёт вместе с разговором.
Как меняется расход у llama3.1:8b в Q4_K_M:
| Контекст | Примерно страниц текста | Кэш | Всего |
|---|---|---|---|
| 2048 токенов | 3 | 0,3 ГБ | 5,6 ГБ |
| 4096 токенов | 6 | 0,5 ГБ | 5,8 ГБ |
| 8192 токена | 12 | 1,0 ГБ | 6,3 ГБ |
| 16 384 токена | 25 | 2,0 ГБ | 7,3 ГБ |
| 32 768 токенов | 50 | 4,0 ГБ | 9,3 ГБ |
При контексте 32 тысячи токенов кэш весит почти как сама модель. У новых моделей кэш бывает заметно экономнее: например, у qwen3.5 и gemma4 большая часть слоёв помнит только последние слова или хранит сжатое состояние, и их кэш в несколько раз меньше. Калькулятор это учитывает.
Сколько контекста даёт Ollama по умолчанию, зависит от видеопамяти: меньше 24 ГБ - 4096 токенов, от 24 до 48 ГБ - 32 768, от 48 ГБ - 256 тысяч. Поменять можно в настройках приложения Ollama или переменной среды OLLAMA_CONTEXT_LENGTH. Проверить, какой контекст сейчас у модели, можно командой ollama ps, колонка CONTEXT.
Если памяти не хватает совсем чуть-чуть, помогает сжатие самого кэша: переменная среды OLLAMA_KV_CACHE_TYPE со значением q8_0 уменьшает кэш примерно вдвое почти без потери качества. В калькуляторе это пункт «Кэш контекста: сжатый».
Что будет, если модель не влезает
Ollama не откажется запускать модель. Он положит в видеопамять столько, сколько поместится, а остальное оставит в оперативной памяти и будет считать на процессоре. Команда ollama ps покажет это в колонке PROCESSOR, например 48%/52% CPU/GPU.
Проблема в скорости. Процессор и оперативная память работают намного медленнее видеокарты, и вся модель ждёт самую медленную часть. Цифры из моего замера на карте с 4 ГБ:
| Модель | На видеокарте | Видеокарта, токенов/с | Только процессор, токенов/с |
|---|---|---|---|
| granite4.2:3b | 100 % | 43,3 | 10,1 |
| llama3.2:3b | 96 % | 42,4 | 10,3 |
| qwen3:4b | 78 % | 17,9 | 8,1 |
| gemma3:4b | 46 % | 12,2 | 8,1 |
| qwen3.5:4b | 51 % | 7,2 | 6,5 |
Модели, которые поместились целиком или почти целиком, работают в 4 раза быстрее процессора. А qwen3.5:4b, которая поместилась наполовину, на видеокарте почти не быстрее, чем вообще без неё.
Вывод: частичная загрузка - это не «чуть медленнее», а часто «почти как на процессоре». Если модель влезает меньше чем на две трети, лучше взять модель поменьше или уменьшить контекст. В том же замере уменьшение контекста с 4096 до 2048 токенов ускорило gemma3:4b с 12,2 до 15,9 токена в секунду.
И ещё: модели, которая не влезла в видеопамять, нужна оперативная память под остаток. Если не хватит и её, Windows начнёт использовать файл подкачки на диске, и всё станет совсем медленным.
Модели MoE: большие, но шустрые
В названиях некоторых моделей есть буквы «a» с цифрой: qwen3.5:35b-a3b, gemma4:26b-a4b. Это модели типа MoE («смесь экспертов»). Внутри у них много отдельных блоков-«экспертов», и для каждого слова работают только некоторые. У qwen3.5:35b-a3b всего 35 миллиардов параметров, но на каждое слово считаются только 3 миллиарда. К этому же типу относится gpt-oss:20b от OpenAI: 21 миллиард параметров, из них активных 3,6 миллиарда.
Для памяти это ничего не меняет: загрузить нужно всю модель, все 35 миллиардов. Зато по скорости MoE-модель ведёт себя как маленькая. Поэтому на процессоре и при частичной загрузке она работает заметно бодрее обычной модели того же размера. Если у вас 8-12 ГБ видеопамяти и 32-64 ГБ оперативной, MoE-модель на 20-35 миллиардов может оказаться вполне рабочим вариантом, хотя калькулятор и покажет её как «частично».
Встроенная графика и компьютер без видеокарты
Без видеокарты нейросеть тоже работает, просто на процессоре. На Ryzen 5 5600G модели на 2-4 миллиарда параметров выдавали от 6,5 до 13 токенов в секунду. Это медленнее, чем на видеокарте, но читать ответ вполне можно. Здесь важна уже оперативная память: модель плюс 4-6 ГБ на систему и браузер. С 8 ГБ берите модели до 3 ГБ, с 16 ГБ можно модели на 8 миллиардов.
Встроенная графика (Ryzen с буквой G, Intel UHD и Iris Xe) своей памяти не имеет, она берёт часть оперативной. Ollama умеет работать с ней через Vulkan, но сильного ускорения ждать не стоит: модель упирается в скорость той же самой оперативной памяти. Я этот вариант не проверял.
Если нейросеть нужна всей семье, её всё равно лучше запускать на основном компьютере с видеокартой. Маленький экономичный домашний сервер хорош для хранения файлов и фотографий, а для нейросети ему не хватит видеопамяти.
NVIDIA, AMD, Intel или Mac
- NVIDIA. Самый беспроблемный вариант: всё работает через CUDA сразу после установки драйвера. Ollama поддерживает карты с compute capability 5.0 и новее (это примерно GTX 750 Ti и всё, что вышло позже) с драйвером 550 и новее.
- AMD. Родная технология ROCm в Windows официально поддерживает только новые карты, начиная с Radeon RX 7600. Остальные, например серию RX 6000, Ollama запускает через Vulkan. На моей RX 6500 XT это работало без настроек.
- Intel Arc. Работают через Vulkan. Это самый молодой вариант, перед покупкой карты Intel именно под нейросети стоит поискать свежие отзывы.
- Mac с чипами M1-M4. У них нет отдельной видеопамяти, видеоядро берёт общую память компьютера. По умолчанию ему доступно примерно две трети-три четверти от всего объёма: на Mac с 16 ГБ под модель будет около 10-12 ГБ, на Mac с 64 ГБ - около 48 ГБ. Поэтому Mac с большим объёмом памяти - один из самых простых способов запустить большую модель дома. В калькуляторе выбирайте объём «видеопамяти», равный примерно двум третям памяти Mac, и снимайте галочку про монитор.
Для сравнения видеокарт по скорости важен не только объём, но и скорость видеопамяти: чем она выше, тем быстрее пишутся ответы. Но сначала всегда объём: быстрая карта, в которую модель не влезла, проиграет медленной, в которую влезла.
Частые вопросы
Можно ли сложить память двух видеокарт?
Да, Ollama умеет делить модель между несколькими видеокартами одного компьютера. Но каждая карта тратит свой запас на служебные нужды, так что складывайте объёмы с запасом.
Почему калькулятор говорит «влезает», а Ollama пишет, что часть модели на процессоре?
Ollama оценивает память осторожно и оставляет себе запас, особенно у моделей, которые понимают картинки. Если модель «влезает впритык», уменьшите контекст или закройте программы, которые используют видеокарту: игры, браузер с видео, редакторы. Проверить результат можно командой ollama ps.
Что лучше: большая модель в сильном сжатии или маленькая без сжатия?
Большая в Q4_K_M. Сжатие до Q4 почти не портит модель, а разница между 8 и 14 миллиардами параметров заметна сразу. Опускаться ниже Q4 (Q3, Q2) стоит только от безысходности.
Сколько нужно оперативной памяти?
Минимум 16 ГБ для комфортной работы с моделями до 8 миллиардов. Если модель не помещается в видеокарту целиком или вы пробуете MoE-модели, лучше 32 ГБ.
Можно ли запустить нейросеть в Docker?
Можно, у Ollama есть официальный образ. Но для видеокарты в контейнере нужна дополнительная настройка, а памяти он потребует столько же. Что такое Docker и зачем он нужен, разобрано в статье Docker для новичков.


Комментарии
Пока никто не написал. Будьте первым.